




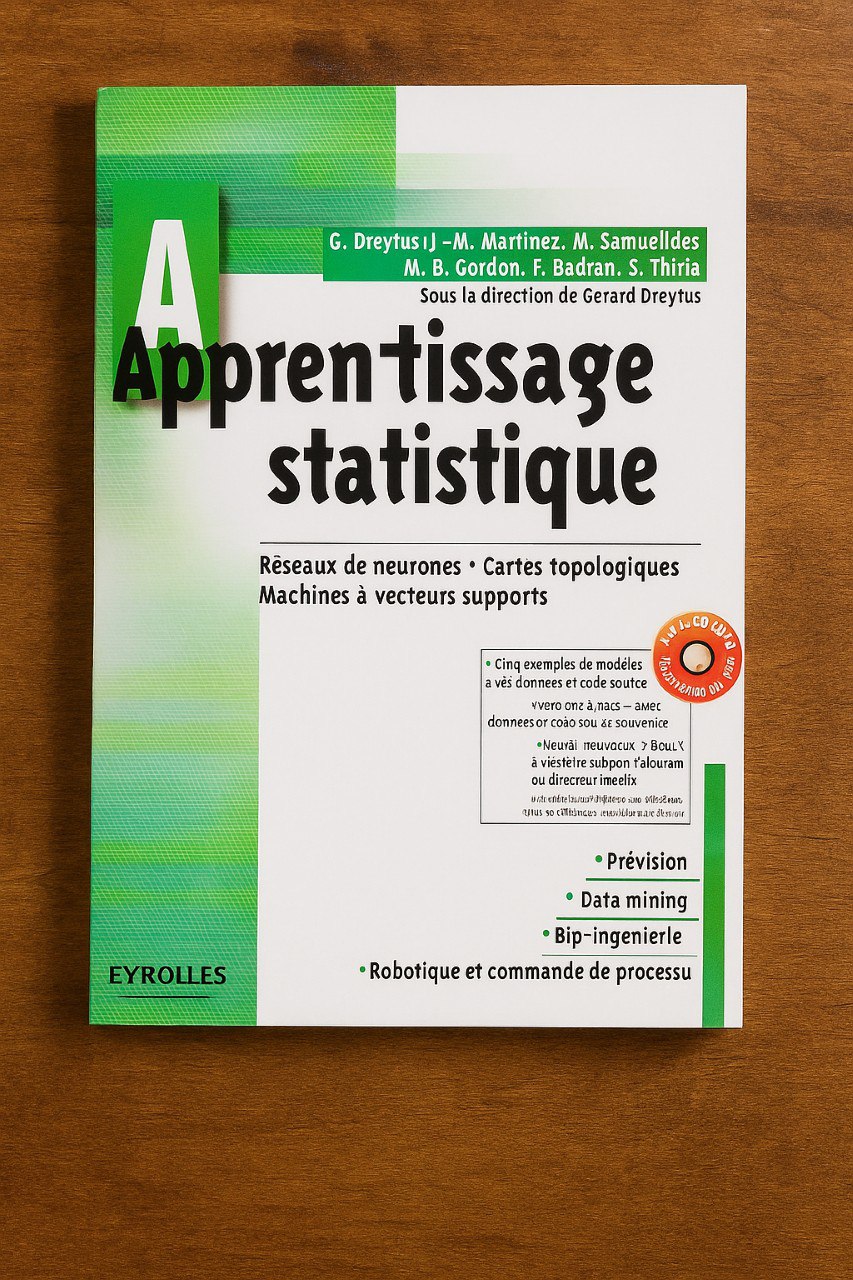
📘 Apprentissage statistique : Réseaux de neurones, Cartes topologiques, Machines à vecteurs supports (Algorithmes) – French Edition
Ce livre propose une exploration approfondie des principales méthodes d’apprentissage statistique utilisées en intelligence artificielle et en data science moderne.
À travers une approche théorique rigoureuse et une mise en pratique algorithmique, l’ouvrage détaille trois piliers majeurs du machine learning :
-
Les réseaux de neurones
-
Les cartes topologiques
-
Les machines à vecteurs supports (SVM)
Il s’adresse aux étudiants, chercheurs, ingénieurs et professionnels souhaitant comprendre non seulement l’utilisation, mais aussi les fondements mathématiques et algorithmiques de ces modèles.
Contenu détaillé Fondements de l’apprentissage statistique
-
Rappel des bases en probabilités et statistiques
-
Théorie du risque empirique
-
Généralisation et surapprentissage
-
Validation croisée et sélection de modèles
Réseaux de neurones
Présentation complète des architectures et mécanismes d’apprentissage :
-
Perceptron et réseaux multicouches
-
Algorithme de rétropropagation (backpropagation)
-
Fonctions d’activation
-
Descente de gradient
-
Régularisation
-
Introduction aux architectures profondes
Objectif : comprendre le fonctionnement mathématique interne et implémenter un réseau simple.
Cartes topologiques (Self-Organizing Maps)
Étude des cartes auto-organisatrices :
-
Principe de l’apprentissage non supervisé
-
Organisation spatiale des données
-
Préservation de la topologie
-
Algorithme de Kohonen
-
Applications en classification et visualisation
Objectif : maîtriser les méthodes de projection et de clustering.
Machines à vecteurs supports (SVM)
Approche détaillée :
-
Séparabilité linéaire
-
Marges maximales
-
Dualité et optimisation quadratique
-
Trick du noyau (Kernel trick)
-
SVM pour classification et régression
Objectif : comprendre l’optimisation sous contrainte et l’interprétation géométrique des SVM.
Éléments pédagogiques inclus
✔ Démonstrations mathématiques
✔ Algorithmes détaillés
✔ Exemples numériques
✔ Études de cas
✔ Illustrations graphiques
✔ Comparaisons entre méthodes
Objectifs du livre
Après lecture, le lecteur sera capable de :
-
Comprendre les fondements théoriques du machine learning
-
Implémenter des algorithmes de classification et de clustering
-
Choisir le modèle adapté selon le problème
-
Analyser la performance d’un modèle
-
Comprendre les enjeux de généralisation
-
Interpréter les résultats obtenus
Public cible
-
Étudiants en informatique, mathématiques, statistiques
-
Étudiants en intelligence artificielle
-
Data scientists débutants ou intermédiaires
-
Ingénieurs en analyse de données
-
Chercheurs souhaitant consolider leurs bases théoriques
Résultats concrets pour le lecteur
En appliquant les concepts du livre, le lecteur pourra :
-
Construire des modèles prédictifs fiables
-
Réduire les erreurs de classification
-
Optimiser la performance d’un système intelligent
-
Comprendre les mécanismes d’apprentissage automatique
-
Développer des projets académiques ou professionnels solides
Positionnement
Ce livre se distingue par :
-
Une approche à la fois mathématique et pratique
-
Une structuration progressive
-
Une pédagogie claire en français
-
Une mise en relation des méthodes classiques et modernes
Avis
Il n’y a pas encore d’avis.